HBM4はメモリかロジックか?TSMCに利益を奪われる供給網の真実
※本記事はプロモーションを含みます。
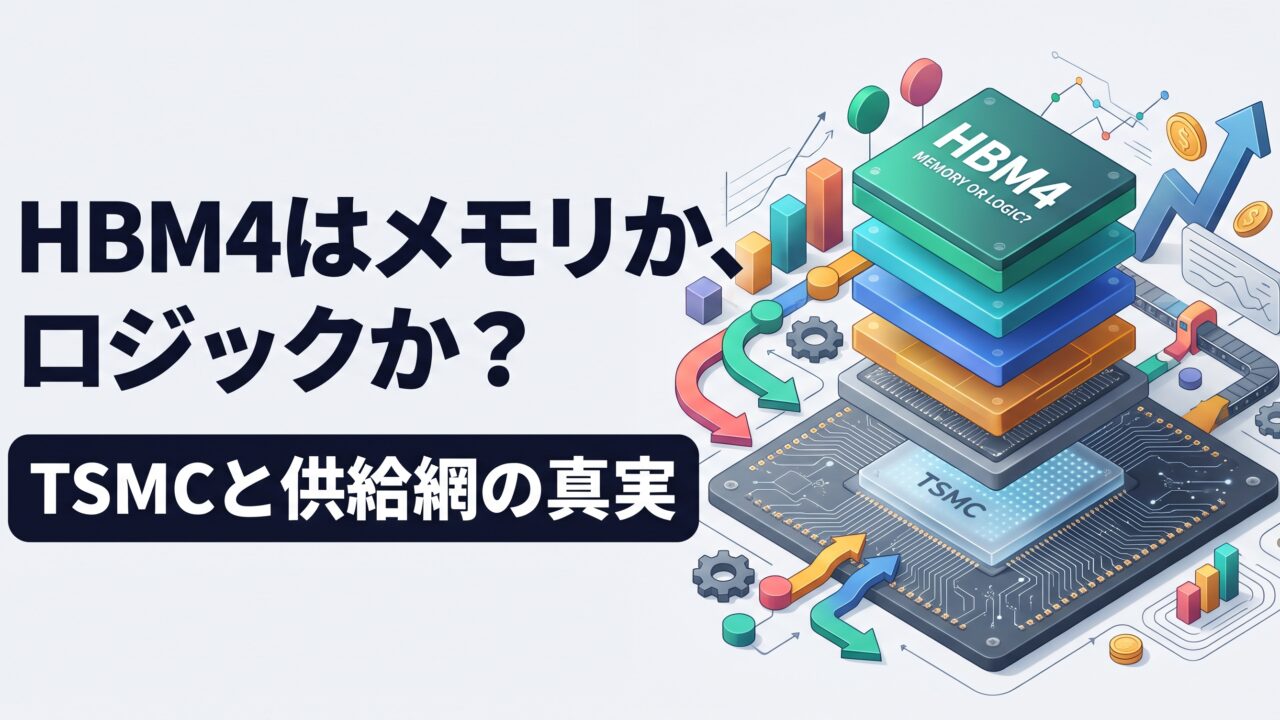
次世代広帯域メモリ「HBM4」の登場により、半導体業界の勢力図が根底から覆ろうとしています。これまでDRAMメーカーの領分だったメモリ最下層の「ベースダイ(バッファダイ)」製造がTSMCなどの先端ファウンドリへ委託され、メモリと最先端ロジックが物理的に融合する構造転換が始まったためです。
この変化は単なるスペック向上にとどまりません。NVIDIA(エヌビディア)の次世代GPUアーキテクチャ「Vera Rubin(ルービン)」世代を睨み、価格決定権の所在がメモリメーカーから先端ファウンドリへ不可逆的にシフトすることを意味します。本記事では、HBM4の構造的本質からサプライチェーンの力学、投資判断の分岐点までを立体的に解剖します。
次世代規格「HBM4」とは何か:ベースダイのロジック化がもたらす構造破壊
HBM4の決定的なブレイクスルーは、インターフェース幅が前世代HBM3Eの1,024-bitから2,048-bitへと一挙に倍増(+100%)することです。配線密度が物理的限界に達した結果、メモリの土台であるベースダイに先端ロジックプロセス(4nm/3nmクラスなど)の適用が不可欠となりました。
従来のHBM(〜HBM3E)は、最下層のベースダイも上層のDRAMセルと同じメモリ製造ライン(10nm級プロセス)で製造されていました。いわば規格さえ合致すればどのプロセッサにも積載できる「既製品の多層マンション」だったと言えます。
対照的にHBM4は、GPU並みの頭脳を持つ特注スマートビルへと変貌を遂げます。2,048本ものTSV(シリコン貫通電極)を極小面積に配置し、GPU側のメモリコントローラや物理インターフェース(PHY)回路の一部をベースダイ側へ移管・ロジック混載するため、旧来の低密度DRAMラインでは物理的に回路を収容しきれなくなったのです。
| 規格・世代 | HBM3E(現行主力) | HBM4(次世代規格) | 進化のインパクトと要因 |
|---|---|---|---|
| I/O インターフェース幅 | 1,024-bit | 2,048-bit | 配線本数が2倍。広帯域化と同時に配線過密化を誘発 |
| スタックあたり帯域幅 | 約 1.2 TB/s | 最大 2.0 TB/s 〜 3.3 TB/s | 1.7〜2.6倍の転送速度で「メモリウォール」を打破 |
| ベースダイ製造プロセス | DRAMプロセス(10nm級) | 先端ロジック(4nm / 3nm / 12nm等) | 先端ファウンドリ(TSMC等)への製造依存が必須化 |
| 製品属性 | 標準規格・準汎用品 | カスタム集積体(NVHBM等) | 顧客(NVIDIA等)ごとの特注最適化が主流へ |
プロセッサの計算能力に対してデータ転送速度が追いつかない「メモリウォール(Memory Wall)」の深刻化が、この力学変化を後押ししています。超高密度な微細ロジックをメモリの土台に埋め込むことで、信号遅延と消費電力を極限まで削ぎ落とすカスタムHBMへの移行が進んでいます。
半導体サプライチェーンの地殻変動:なぜTSMCへの集中が加速するのか
HBM4化に伴うサプライチェーン最大の地殻変動は、TSMC(TSM)がGPU本体のみならず「メモリの根幹」まで独占支配する構造が完成することです。SK hynix(SKハイニックス)をはじめとするメモリ各社がベースダイ製造をTSMCへ委託する協業体制を敷いたためです。
IDM(垂直統合型デバイスメーカー)として自社ファウンドリを有するSamsung Electronics(サムスン電子)でさえ、NVIDIA向け供給においては顧客の要求によりTSMC製造のベースダイ採用を検討せざるを得ない力学が働いています。NVIDIAが主導するAIエコシステムはTSMCの先端プロセスおよび先端パッケージング「CoWoS(Chip on Wafer on Substrate)」を前提に設計されており、歩留まりリスクを嫌う顧客側がTSMC製ベースダイを優先するためです。
| プレイヤー / 陣営 | 主要アライアンス・技術仕様 | 構造的強み | 構造的弱み・リスク |
|---|---|---|---|
| SK hynix × TSMC 連合 | MR-MUF技術 + TSMC(12nm/3nm)ベースダイ | 圧倒的なHBM3E量産実績と高い歩留まり。早期立ち上げ優位 | ベースダイ製造マージンをTSMCに流出。TSMC枠の争奪戦 |
| Samsung Electronics | 自社DRAM + 自社先端ファウンドリ(4nm等)一貫生産 | 完全内製(IDM)によるTAT(納期)短縮と低コスト構造 | 自社ファウンドリの歩留まり証明課題。顧客認定の遅延懸念 |
| Micron Technology × TSMC | 1β/1γ DRAM + TSMC委託 | 高いエネルギー効率設計と米国政府の補助金・地政学支援 | 韓勢に対するキャパシティ絶対量の不足。TSMC依存度の高さ |
この結果、TSMCはGPUダイ、インターポーザ、そしてHBMベースダイという「AIモジュールの3大要衝」すべてからマージンを吸い上げる体制を固めました。先端半導体の利益の急所(チョークポイント)は、DRAMセルを作るメモリメーカーから、それらを結節する微細ロジックとパッケージングを握るファウンドリへと完全に移行しています。
🔎 テック・半導体市場を読み解く「専門知」を養う
サプライチェーンの力関係や最先端技術の潮流を体系的に学ぶには、体系化された専門書が近道です。
市場の構造変化を見抜く力を養うための関連書籍をチェックしてみましょう。
)
建前と現実:歩留まりの壁とTSMCの「トリプル・チョークポイント」
各社IRがアピールする「HBM4による帯域倍増と順調な量産開始」というアナウンスメントの裏側には、極めて過酷な物理的歩留まりの壁が存在します。
第1の壁は、超多ピン接合に伴う物理的歪みです。2,048本もの微細配線を持つダイを12段〜16段に積み上げる工程では、異なる部材間の熱膨張係数(CTE)のミスマッチにより、ウェハーの反り(Warpage)が発生しやすくなります。積層数が増えるほど指数関数的に総合歩留まりが低下するため、初期量産フェーズでのコスト高止まりは避けられません。
第2の壁は、TSMC内部で生じる「トリプル・チョークポイント(3重の供給枠争奪戦)」です。HBM4世代では、GPUダイ本体、先端パッケージング(CoWoS)、そしてHBMベースダイのすべてがTSMCの限られた先端設備を取り合います。どれか1つでもラインが滞留すれば、モジュール全体の出荷が急停止する脆さを内包しています。
さらにAIインフラ全体に目を向ければ、先端チップの供給以前にデータセンターの電力網接続待ちやネオクラウド事業者の資本調達コスト上昇など、実稼働を阻む物理的・財務的ボトルネックが顕在化しつつあります。最先端半導体の青写真通りにインフラ投資が実を結ぶか否かは、こうした製造・インフラ双方の現実的摩擦を乗り越えられるかにかかっています。
投資家のジレンマ:メモリメーカーの利益希薄化と見直しのトリガー
株式市場では「AI需要拡大に伴うHBM高単価の継続」という強気論が根強い一方、プロ投資家の間では「メモリメーカーの粗利率圧迫」に対する警戒感が急速に強まっています。
最大の懸念は、高付加価値なベースダイ製造をTSMCへ委託することで、利益の源泉がファウンドリ側へ吸い上げられる点です。加えて、NVIDIAは供給網の安定化と調達コスト抑制を狙い、ベースダイ設計の標準化を推進しています。複数メーカーからのマルチソーシング(相見積もり)を容易にすることで、メモリメーカーの価格交渉力を弱める戦略を敷いています。
DRAM市場は歴史的に、需要が実数ベースで拡大していても前年比の成長率が鈍化した瞬間に株価が急落する「シリコンサイクル」を繰り返してきました。HBMがカスタム品化しても、製造原価の増大と成長率の鈍化が重なれば、バリュエーションの急速な調整を招くリスクがあります。
📊 AIインフラ・米国成長株への投資基盤を整える
急成長を続ける半導体・AIインフラ関連の米国株は、1株単位からポートフォリオに組み入れ可能です。
松井証券なら、充実した取引環境と業界最安水準の手数料体系で、機動的な資産形成をサポートします。
)
※口座開設は無料。最短即日で完了します。
投資シナリオを見直すべき客観的トリガーとして、以下の3点を注視する必要があります。
- 主要顧客(NVIDIA等)による認証遅延: HBM4の最終クオリフィケーションが半年以上遅れた場合、競合へのシェア喪失や製造コスト増が直撃します。
- TSMC先端枠の逼迫に伴う出荷停滞: CoWoSや先端ロジック枠の不足により、HBM4の引き取りが遅延して在庫が滞留するリスクです。
- ハイパースケーラーのCapEx回収懸念: モデルの小型化や推論効率化により、超高額なHBM4搭載クラスタへの巨額投資ペースが鈍化した場合です。
よくある質問(FAQ)
Q1. なぜDRAMメーカーはHBM4のベースダイを自社で作らずTSMCに頼るのですか?
HBM4では配線(TSV)が2,048本へ倍増し、GPUとの通信コントローラやPHY回路がベースダイ側に移管されるためです。従来のDRAM製造工程(10nm級)のトランジスタ密度では配線が収容しきれず、微細な3nmや4nmクラスのロジック回路を安定製造できる先端ファウンドリの支援が不可欠となりました。
Q2. メモリを一貫生産(IDM)できるサムスン電子に逆転の勝ち目はありますか?
理論上、DRAMからロジック製造、先端パッケージングまで自社完結できるサムスン電子は、納期短縮(TAT)と製造原価の面で最大の潜在力を持ちます。しかし、NVIDIA等の顧客がTSMCエコシステムとの親和性や実績を重視しているため、自社先端ラインの歩留まり安定と厳格な品質基準をクリアできるかが逆転の絶対条件となります。
Q3. HBM4への移行で最も恩恵を受け、構造的リスクが低い銘柄はどこですか?
最も強固な立ち位置を確保しているのはTSMCです。GPUダイの製造に加え、SK hynixやMicron Technology、さらにはサムスンの一部ベースダイ受託や最終パッケージングまで包括するため、メモリメーカー間のシェア争いに関わらず高マージンを吸い上げる構造を確立しています。
まとめ:勝敗の焦点は「DRAM積層技術」から「先端ファウンドリとの統合力」へ
HBM4の到来は、メモリが単なる「標準化された記録媒体」から、プロセッサと密結合した「先端ロジック・カスタム集積体」へと決定的に進化したことを告げています。
これからの市場競争における勝敗の分かれ目は、単なるDRAMの微細化や積層段数競争ではありません。「先端ロジックをいかに低コストかつ高歩留まりで統合できるか」という実装力が問われるフェーズに入りました。
TSMCによる独占的チョークポイントの強化、NVIDIAによる標準化要求、そして各メモリメーカーの実行力格差を見極めることが、次世代半導体市場を勝ち抜くための不可欠な羅針盤となります。