NVIDIA GPUロードマップ解説|Rubinはいつ?Blackwell後の進化
※本記事はプロモーションを含みます。
米NVIDIA(エヌビディア)の成長を牽引するAI向けGPUは、従来の2年周期を脱し「1年ごとの世代交代(One-Year Cadence)」へと加速しています。主力となるBlackwell(B200/GB200)の本格普及が進むなか、投資家やテック関係者の関心はすでに次世代アーキテクチャ「Rubin(ルビン)」の実用化時期と性能差へと向かっています。
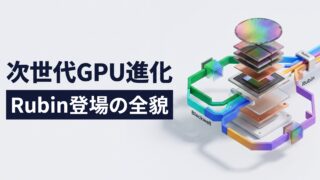
次世代GPU「Rubin」の量産・投入は2026年後半に予定されており、世界初となる次世代メモリ「HBM4」の8スタック構成を実装します。単なる理論性能の向上にとどまらず、ラックスケールの冷却や電力効率、さらにはハイパースケーラーの投資対効果(ROI)を左右する構造的転換点となります。
本稿では、BlackwellからRubin、さらにその先のRubin Ultraに至るNVIDIA GPUロードマップの全貌を整理し、サプライチェーンのボトルネックや市場のリアルな投資ジレンマまで踏み込んで徹底分析します。
NVIDIA GPUロードマップ完全比較表【BlackwellからRubinへ】
検索ユーザーが最も注視する「世代別の投入時期」「メモリ規格」「冷却要件」の推移を一覧表にまとめました。2024年末から2025年にかけてのBlackwell立ち上がりを経て、2026年のRubinへの移行フェーズが鮮明になっています。
| 世代・モデル名 | 本格投入時期 | アーキテクチャ刷新の要点 | 搭載メモリ・容量 | 標準冷却方式 |
|---|---|---|---|---|
| Hopper (H100 / H200) |
2022年〜2023年 | 生成AIブームの原点。市場独占を築いた基幹アーキテクチャ | HBM3 / HBM3e (最大141GB) |
空冷中心 (一部液冷) |
| Blackwell (B200 / GB200) |
2024年後半〜2025年 | 2ダイを1パッケージに統合(2,080億トランジスタ)。推論性能が飛躍 | HBM3e (192GB) |
直接液冷(DLC) 本格標準化 |
| Blackwell Ultra (B300 / GB300) |
2025年後半 | Blackwellの拡張版。メモリスタックを12層化し大容量化 | HBM3e (12H) (288GB) |
完全液冷ラック |
| Rubin (R100 / VR200) |
2026年後半 | 先端ロジックをベースダイに採用するHBM4を初採用。CPU「Vera」と統合 | HBM4 (8スタック) |
高密度液冷 (100kW超/ラック) |
| Rubin Ultra | 2027年予定 | Rubinの最上位構成。16スタックのHBM4を搭載し巨大推論基盤を支配 | HBM4 (16スタック) |
ラック単位完全液冷 |
ロードマップの最大のハイライトは、2026年に登場するRubin世代でのHBM4全面採用です。転送帯域幅の劇的な拡大により、数兆パラメータ規模の超巨大AIモデルにおける推論ボトルネックを根本から解消する設計となっています。
次世代GPU「Rubin(ルビン)」はいつ登場するのか?進化の全容
「Rubinはいつ実用化されるのか」という問いに対する結論は、2026年中の市場投入・同年後半からの本格量産です。Blackwell Ultra(2025年後半)を経て、計画通りのサイクルで展開される見通しです。
RubinアーキテクチャがAI半導体業界にもたらす革新は、主に以下の3点に集約されます。
- HBM4の本格採用:ベースダイにファウンドリの最先端プロセスを採用することで、メモリ帯域幅を飛躍的に拡張し、GPUとメモリ間のデータ転送速度を新次元に引き上げます。
- 新世代スーパーチップ「Vera Rubin」:自社設計のARMベース次世代CPU「Vera」とGPU「Rubin」を高速相互接続し、システム全体のエネルギー効率を極限まで最適化します。
- ラックスケールアーキテクチャの高度化:単体GPUの性能競争から、ラック全体を1つの仮想GPUとして機能させる分散処理能力の最大化へと軸足を完全に移行します。
このように、Rubinは単なるGPUチップの刷新ではなく、CPU・メモリ・インターコネクトが三位一体となった次世代コンピューティング・プラットフォームとしての性質を帯びています。
📊 AIインフラ・米国成長株への投資基盤を整える
急成長を続ける半導体・AIインフラ関連の米国株は、1株単位からポートフォリオに組み入れ可能です。
松井証券なら、充実した取引環境と業界最安水準の手数料体系で、機動的な資産形成をサポートします。

※口座開設は無料。最短即日で完了します。
「1年サイクル(One-Year Cadence)」の建前と現場の現実
ジェンスン・フアンCEOが掲げる「1年サイクル」は、AMDや巨大テック企業の内製チップ陣営に対し、「追いつく隙を与えずに逃げ切る」ための強力な参入障壁として機能しています。しかし、その華々しい建前の裏には、サプライチェーンと顧客環境における重い現実が存在します。
最大の懸念は、クラウド事業者(ハイパースケーラー)側の投資回収(ROI)サイクルとの乖離です。データセンターの設備償却期間が通常3〜5年であるのに対し、基幹プロセッサが毎年型落ちとなるスピード感は、顧客の設備投資負担を過剰に押し上げます。
現にMicrosoftは、Broadcom(ブロードコム)と連携して推論特化型AI半導体「Maia 300」の数十万基規模での自社導入を進めています。高額なNVIDIA製GPUの調達コストを回避し、電話会議の要約や定型的な問い合わせ処理を低コストな内製チップへと振り分ける動きが加速しています。
さらに、中国市場向け輸出規制への対応として、NVIDIAは性能を調整したカスタムGPUを投入し、バイトダンスやアリババ等から350億ドル規模の受注を獲得しています。規制環境の激変と内製化の挟間で、単一のロードマップに依存しない柔軟な製品展開が求められています。
サプライチェーンの力関係と3大ボトルネック
ロードマップの完遂において、NVIDIAがすべての主導権を握っているわけではありません。生産・実装の各段階において、明確な構造的チョークポイントが存在します。
1. 先端パッケージング(TSMC CoWoS)のキャパシティ
BlackwellやRubinのような巨大ダイの統合は、TSMCの後工程技術「CoWoS」なしには成立しません。ファウンドリ側のライン増強ペースが、そのままNVIDIAの売上高の上限を規定する力関係が続いています。
2. HBM4の製造難易度とメモリサイクルの波
Rubinで採用されるHBM4は、従来のDRAM製造プロセスに加え、ベースダイに最先端のロジックプロセスを必要とします。SKハイニックスやマイクロン・テクノロジー(MU)の歩留まりが供給の生命線となります。
一方で、中国CXMT(長鑫存儲)の台頭など汎用DRAMの競争環境も変化しており、AIハードウェア全体の旺盛な需要とは裏腹に、メモリ市場の成長率鈍化が先行して警戒される特有のサイクルリスクを内包しています。
3. データセンターの物理的限界(電力・送電網)
GPUの集積密度向上に伴い、冷却方式は従来の空冷から直接液冷(DLC)への全面移行を余儀なくされています。ラックあたりの消費電力が100kW規模に達するなか、施設側の受電容量が追いつかない事態が頻発しています。
実際、Microsoftが英Nscaleとのデータセンター契約を電力供給遅延を理由に解除した事例が示すように、送電網接続の遅れがGPUの納入そのものを阻む最大の物理的障壁となっています。
🔎 テック・半導体市場を読み解く「専門知」を養う
サプライチェーンの力関係や最先端技術の潮流を体系的に学ぶには、体系化された専門書が近道です。
市場の構造変化を見抜く力を養うための関連書籍をチェックしてみましょう。

投資家のジレンマ:強気シナリオと警戒すべき3つのシグナル
NVIDIAの描くロードマップが株式市場で高く評価される一方、市場関係者の間では「AI投資の過熱感」に対する慎重論も根強く交錯しています。投資判断を分かつポイントは以下の3点です。
1. 資本効率と「浪費」への警戒
Broadcomのホック・タンCEOが指摘するように、一部のAI開発企業における巨額投資が持続的な収益に結びつくかという疑問は解消されていません。需要そのものは堅調であっても、資本コストの増大が将来のハードウェア調達ペースを抑制するリスクは常に意識すべきです。
2. ネオクラウドの信用リスクと資金繰り
CoreWeaveをはじめとするGPU特化型の新興クラウド事業者は、高利回り社債やデットファイナンスを原資にインフラ拡張を進めています。信用スプレッドの拡大や資金調達コストの上昇は、サーバー納入の遅延や投資縮小に直結する先行指標となります。
3. 大型IPOと株式需給のバランス
未公開の大手AIモデル開発企業による超大型資金調達や新規上場(IPO)の動きは、上場ハイテク株に滞留していた機関投資家の資金を分散・流出させる要因となり得ます。好決算であっても需給要因で株価の上値が重くなる局面に注意が必要です。
よくある質問(FAQ)
Q1. NVIDIAの次世代GPU「Rubin(ルビン)」はいつ発売されますか?
Rubinは2026年後半に本格投入されるロードマップとなっています。2025年後半に市場投入される改良版「Blackwell Ultra(B300/GB300)」を経て、次世代メモリHBM4を搭載したフラッグシップとして展開されます。
Q2. GeForce RTX 50シリーズなど家庭用GPUも同じロードマップですか?
アーキテクチャの基本設計思想は共有されますが、製品ロードマップのスケジュールは異なります。TSMCの先端ラインはデータセンター向けが最優先で割り当てられ、コンシューマー向けGeForce製品は順次異なる生産ペースで投入されます。
Q3. ロードマップの遅延が発生した場合の投資判断基準は何ですか?
単なる開発発表ではなく、TSMCのCoWoS生産能力の拡充状況、液冷インフラの現場導入スピード、そして主要クラウド顧客の設備投資計画(CapEx)の推移を定点観測することが極めて重要な判断基準となります。
今後の展望:インフラ全体の総合力を見極める
NVIDIAのGPUロードマップは、単体の半導体スペックを競う時代から、メモリ、液冷、ネットワーク、電力を統合したシステム競争へと完全にフェーズを移行しました。
BlackwellからRubinへの移行過程においては、半導体単体の出荷数だけでなく、液冷インフラを手掛けるサプライヤーや次世代HBMを供給するメモリメーカーの動向を含めた、エコシステム全体のキャパシティを冷静に見極める視点が不可欠です。