シリコンフォトニクスとCPO導入:通信電力80%削減の真実
※本記事はプロモーションを含みます。
次世代AIデータセンターの拡張は、もはやGPUの演算性能ではなくGPU間通信の電力・熱限界という物理的な壁に衝突しています。1チャネルあたり200Gbps、スイッチ総帯域が100Tbpsを超える領域では、従来の銅線配線やプラガブル光モジュールによる伝送損失と発熱が許容値を超え、AIインフラのスケールアウトを阻む最大のチョークポイントとなりました。
この電力の断崖絶壁を打破する決定打が、電子チップと光エンジンを同一基板上に超高密度で統合するシリコンフォトニクス(光電融合・CPO)です。TSMCのCOUPE量産本格化や主要CSPの導入ロードマップが進む中、単なる研究開発段階を脱し、半導体サプライチェーン全体の付加価値構造を激変させる実用化フェーズへと突入しています。
本記事では、CPOが不可欠となる技術的背景から、2026年以降の商用化ロードマップ、実装を阻む「製造・熱・保守」の三重苦、そしてTSMCを中心とするサプライチェーンの覇権争いまで、一次情報と構造的ファクトを基に徹底解剖します。
シリコンフォトニクス(光電融合・CPO)とは:通信電力を80%削減する仕組み
シリコンフォトニクス(SiPh)とは、半導体基板上で電気信号の代わりに「光子(光信号)」を用いてデータ伝送を行う技術であり、その実装の極致がCPO(Co-Packaged Optics)です。従来の電子回路が直面していた電気抵抗による発熱と高周波信号の減衰を解消し、長距離・超広帯域通信を極小の電力で実現します。
従来のデータセンターでは、スイッチASICやGPUから基板上の銅線配線を経由し、ラック前面のプラガブル光トランシーバーまで電気信号を引っ張って光変換を行っていました。しかし、通信速度がチャネルあたり200Gbpsに達すると、基板上の銅線を通るだけで信号が激しく減衰し、それを補正するためのDSP(デジタル信号処理プロセッサ)が膨大な電力を浪費します。
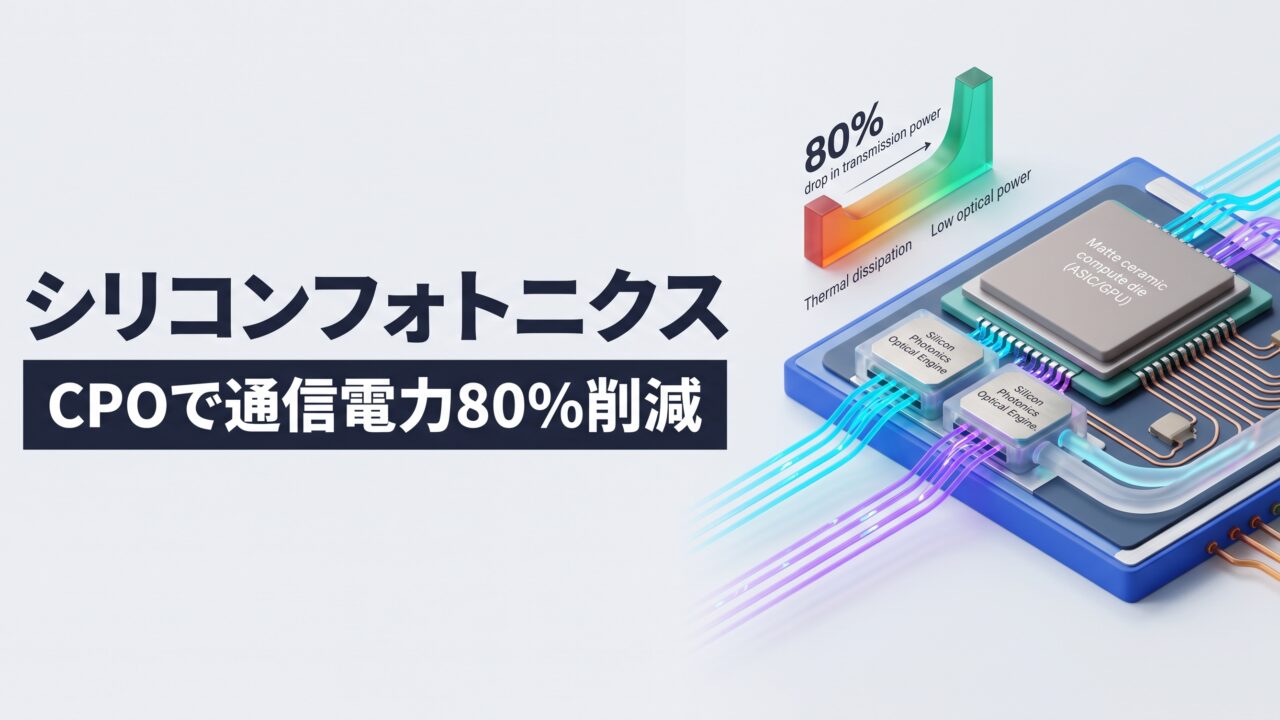
CPOは、光電変換を担う光エンジン(PIC:Photonic Integrated Circuit)をスイッチASICやGPUと同一のサブストレート(基板)上に混載します。電気信号が走る銅線距離をミリ単位へ極小化することで、伝送損失を劇的に抑え、信号処理DSPを排除・簡素化することが可能になります。
この構造改革により、データ伝送時のエネルギー効率は劇的に向上します。従来のプラガブル光トランシーバーが15〜25 pJ/bit(ピコジュール/ビット)を消費していたのに対し、CPOを導入することで1〜3 pJ/bitへと約70〜80%もの通信電力削減が達成されます。
GPU間通信の消費電力限界:なぜ従来の銅線とプラガブルは限界なのか
AIクラスタの大規模化に伴い、データセンター総消費電力の20〜30%を通信インターコネクトと光トランシーバーが占有する事態が発生しています。数十万基規模のGPUを結合する分散学習環境では、ノード間の帯域需要が指数関数的に増大し、通信インフラそのものが電力グリッドの許容量を逼迫させています。
物理的な根本原因は、銅線導体の表面近くを高周波電流が流れる「表皮効果」と誘電損失です。スイッチング帯域が102.4Tbps世代に突入すると、基板配線での電気信号の劣化が極限に達し、超重量のアクティブ銅線(ACC/AEC)を用いても伝送距離はラック内の1〜3m程度が物理限界となります。ラック間をまたぐスケールアウトには光伝送が必須ですが、従来の光トランシーバーを並べる手法ではスイッチ装置自体の発熱密度が限界を超えてしまいます。
近年のAIインフラ開発現場では、送電網への接続待ちや電力供給契約の解除など、エネルギー制約によるインフラ拡張の遅延が頻発しています。コンピュート(演算)に割り当てる電力を確保するためには、インターコネクトの通信電力を削る以外に物理的な選択肢が残されていません。
📊 AIインフラ・米国成長株への投資基盤を整える
急成長を続ける半導体・AIインフラ関連の米国株は、1株単位からポートフォリオに組み入れ可能です。
松井証券なら、充実した取引環境と業界最安水準の手数料体系で、機動的な資産形成をサポートします。

※口座開設は無料。最短即日で完了します。
CPO vs LPO vs 銅線技術:インターコネクト技術比較
次世代AIインフラのインターコネクト市場では、完全統合型のCPO、移行期の本命とされるLPO(Linear Pluggable Optics)、そして極短距離に特化した銅線技術が適材適所の棲み分けとシェア争闘戦を繰り広げています。
| 技術方式 | 主要強み | 構造的制約・弱み | 適用領域・ROI回収 |
|---|---|---|---|
| CPO (TSMC COUPE / Broadcom) |
消費電力を最大80%削減(1〜3 pJ/bit)。100Tbps超で物理限界を突破。 | 光ダイ故障時の修理が極めて困難。先端パッケージング歩留まりと初期コスト。 | 100Tbps超の最上位スイッチ・GPU直結。電力削減により3〜4年で回収。 |
| LPO (リニアプラガブル) |
DSPを省き低電力化。従来の光ポート資産と現場交換性をそのまま維持。 | ホスト側SerDesへの負荷増。200Gbps/ch超での伝送品質・相互接続性確保。 | ラック間中距離(中短期の本命)。既存設備流用で1〜2年回収。 |
| アクティブ銅線 (ACC / AEC) |
極めて安価、高信頼性。光電変換が不要でレイテンシが極小。 | 重量・体積が巨大でエアフローを阻害。5m以上のクラスタ間伝送は不可能。 | 同一ラック内・隣接ラック間(1〜3m)。初日からコスト優位。 |
LPOは既存のポート交換性を維持できるため、過渡期のソリューションとして有力視されています。しかし、チャネルあたり200Gbpsを超える長距離伝送ではシグナルインテグリティの維持が難しく、帯域が爆発するバックボーン通信においては、最終的に物理的配線長を極小化できるCPOへの移行が不可避となります。
建前と現実:CPO量産化を阻む「製造・熱・保守」の三重苦
メーカー各社は「通信電力を最大80%削減できる」というバラ色の建前を強調しますが、実際の製造現場とデータセンター運用においては歩留まり・熱・保守性という3つの重い技術障壁が立ちふさがっています。
1. 光検査のスループット遅延と先端実装歩留まり
半導体テスターによる電気信号の測定と異なり、光導波路の結合損失やレーザー特性の測定には精密な光学的アライメントが求められます。サブミクロン精度の位置合わせを要する光検査は膨大なタクトタイムを消費し、大量生産時におけるスループットの足を引っ張ります。先端パッケージング自体の歩留まり低下に直結する点が第1の壁です。
2. 高熱ASICによる光素子の劣化とELS(外部光源)の必然性
1基あたり1,000Wを超える熱を発するスイッチASICや最新GPUの直近に、熱に弱いInP(インジウムリン)系半導体レーザーを配置することは物理的に不可能です。レーザー素子は85℃を超えると発光効率が急落し、素子寿命が著しく縮小します。このため、レーザー光源だけをラック前面のプラガブルモジュールとして分離するELS(External Laser Source)方式が必須設計となっています。
3. 故障時の連座リスクと液冷導入の強制
従来のプラガブルであれば、故障した数万円のモジュールをホットプラグで抜き差しすれば復旧しました。しかし、CPOで光エンジンが故障した場合、数百万円相当の最上位ASICを搭載したボード丸ごと廃棄・交換する「連座リスク」が生じます。さらに、超高密度基板の熱密度を冷却するため、空冷を完全に捨ててダイレクト・トゥ・チップ(Direct-to-Chip)等の精密な液冷システムの併用が必須条件となります。
🔎 テック・半導体市場を読み解く「専門知」を養う
サプライチェーンの力関係や最先端技術の潮流を体系的に学ぶには、体系化された専門書が近道です。
市場の構造変化を見抜く力を養うための関連書籍をチェックしてみましょう。

サプライチェーンの力関係:誰がCPO時代の利益を握るのか
CPOの実用化が進むにつれて、データセンター向け通信の付加価値は従来の専業光トランシーバー組立メーカーから、先端ファウンドリと高出力光源・精密テスターの供給元へ不可逆的にシフトしています。
TSMC「COUPE」による先端パッケージングの垂直統合
最大の勝者は、独自の光電統合プラットフォーム「COUPE(Compact Universal Photonic Engine)」を擁するTSMCです。TSMCは電子ダイ(EIC)と光ダイ(PIC)をSoIC技術で3次元積層し、さらにCoWoS技術を用いて基板上に統合する体制を構築しました。パッケージング工程を一気通貫で支配することにより、通信インターコネクトの利益を自社エコシステム内へ吸い上げる構造を完成させています。
高出力レーザーダイ(InP)サプライヤーの希少価値
ELSに用いられる高出力CW(連続波)レーザーやInP(インジウムリン)基板の供給網は極めて限定的です。CoherentやLumentumといった、光通信用半導体材料と化合物半導体ファブを保有する専業サプライヤーは、CSP各社のCPO導入において代替の効かない急所(チョークポイント)として価格決定権を握りつつあります。
光ファイバー精密結合・検査装置メーカーの台頭
チップと光ファイバーアレイを数マイクロメートル以下の精度で固定する自動アライメント装置や、高周波光信号をインラインで測定するアドバンテスト等の先端半導体検査装置メーカーも、量産歩留まりを左右する決定的な存在として重要性を増しています。
CPO普及のロードマップと投資家の判断基準
グローバルCPO市場規模は、2026年の約8.5億ドルから2030年には45億ドル超(CAGR約50%超)へ急成長すると予測されています。しかし、投資家は表面的な成長率だけでなく、シナリオ分岐点と撤退トリガーを冷静に見極める必要があります。
| シナリオ | 想定される市場要因と進展 | 投資家への示唆と銘柄選別の視点 |
|---|---|---|
| 強気シナリオ (Bull Case) |
TSMC COUPEが計画通り立ち上がり、次世代スイッチ(102.4T)やGPUクラスタでCPO採用が標準化。データセンター電力規制の前倒しで導入が加速。 | TSMC、Broadcom、Coherent等のコア銘柄にプレミアム評価。通信電力削減によるメガクラスタ構築が進み、AIインフラ全体が再加速。 |
| 弱気シナリオ (Bear Case) |
外部光源(ELS)の故障率改善が遅延し、現場の保守コストが増加。CoWoSのキャパシティがGPUコアへ優先され、PIC混載ラインの拡張が期ズレ。 | LPOの延命によりCPO関連銘柄の売上計上が後ずれ。専業モジュールメーカーのコモディティ化懸念と高バリュエーション調整が発生。 |
投資シナリオの前提崩壊を測る判断基準(撤退トリガー)は極めて明確です。「TSMCの先端光パッケージング歩留まりが改善せず、プラガブル光モジュールと比較したトータル導入コストが3倍以上で高止まりし続ける場合」、あるいは「主要ハイパースケーラーが102.4Tbpsスイッチ世代においてCPO採用を凍結し、LPOの利用継続を2年以上延期した場合」には、過度な期待で買われた関連銘柄のポジション見直しを検討すべきです。
よくある質問(FAQ)
Q1. CPOが普及すると、既存の光トランシーバー専業メーカーは不要になりますか?
即座に不要になるわけではありません。CPOは102.4Tbps以上の最上位スイッチやGPU間接続から段階的に導入され、中距離伝送や既存ラックでは従来のプラガブル(LPO含む)が長期にわたり併存します。ただし、光エンジン(PIC)の内製化や先端ファウンドリのエコシステムに食い込めない単なる組立専業企業は、利益率低下とコモディティ化の強い圧力に晒されることになります。
Q2. なぜレーザー光源をチップの外に置く「ELS方式」が主流なのですか?
理由は耐熱性と保守性の2点です。光を発する化合物半導体レーザーは熱に弱く、1,000W級の熱を発する最新プロセッサの至近に配置すると寿命が極端に縮小します。また、レーザー素子が寿命を迎えた際に高額なプロセッサ基板ごと全損する事態を避けるため、交換が容易な外部モジュールとして分離することが業界標準となっています。
Q3. シリコンフォトニクス関連で個人投資家が注視すべき構造的リスクは何ですか?
先端パッケージング枠の配分優先順位です。現在、ファウンドリの微細接合ライン(CoWoS等)はGPU演算コアの増産で逼迫しています。光ダイ統合ラインへの投資や生産キャパシティの割り当てが後回しにされた場合、需要自体は旺盛であってもCPOの本格的な収益化が期ズレを起こすリスクを注視する必要があります。
まとめ:AIインフラの命運を握る「光の覇権争い」
AIデータセンターの拡張競争は、シリコンチップ単体の演算速度向上から「いかに電力ロスなくチップ間をつなぐか」というインフラ総合戦へと変貌を遂げました。銅線の物理限界が露呈した今、シリコンフォトニクスとCPO技術は、消費電力制約を突破してAIクラスタをスケールさせるための不可欠な生命線です。
投資家としては、単なる技術的な華やかさに目を奪われるのではなく、TSMCを中心とするパッケージングの価格支配力、Coherentなどの光源サプライヤーの供給能力、そしてハイパースケーラーの現場採用ペースを冷徹に見極めることが、これからの半導体・AIインフラ投資において極めて重要な視点となります。